Tests Statistiques avec Spaceship Titanic (1/2)
SpaceShip Titanic est un classique incontournable de Kaggle, conçu comme la suite du célèbre dataset du Titanic. L’objectif est de prédire quels passagers ont été téléportés dans une dimension alternative suite à une collision avec une anomalie spatio-temporelle.
Pour ce nouvel article sur Aventures Data, nous allons utiliser cet univers riche en variables mixtes pour illustrer l’arsenal des tests statistiques indispensables en Data Science..
Partie 1 : Variables Continues
Tests paramétriques vs non paramétriques.
Avant de lancer le moindre test statistique pour valider nos features, il faut trancher un débat fondamental : allons-nous utiliser une approche paramétrique ou non paramétrique ?
Les tests paramétriques (ANOVA, test t de Student) sont les plus puissants pour détecter des signaux subtils, mais ils sont exigeants : ils supposent que nos données suivent une distribution normale (la fameuse courbe en cloche). À l’inverse, les tests non paramétriques (Mann-Whitney, Kruskal-Wallis) se basent sur les rangs. Ils sont robustes aux outliers et aux asymétries, mais un peu moins précis sur des données parfaitement propres.
Le premier réflexe consiste donc à vérifier la normalité de nos variables.
L’âge
Prenons la variable Age. Le test standard pour vérifier la normalité est le test de Shapiro-Wilk. Exécuté sur 5000 passagers, le résultat donne une 𝑝-value de 7.90e-27 : Mathématiquement, l’hypothèse de normalité est rejetée.
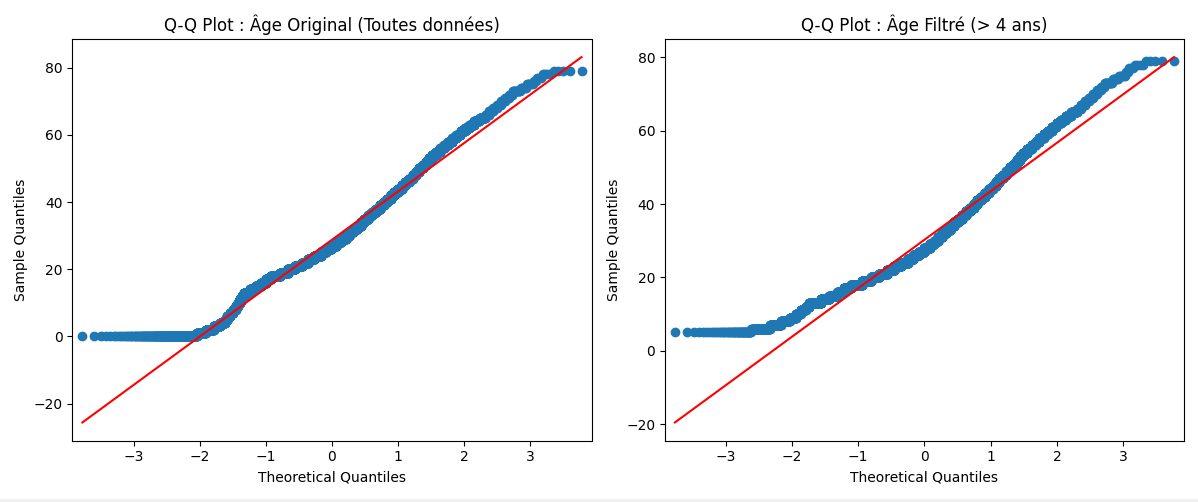
Pourtant, l’asymétrie de la variable (Skewness) n’est que de 0.44. Le Q-Q Plot confirme que la distribution est très bien centrée, exception faite d’un petit palier à l’extrémité gauche causé par une forte proportion de nourrissons (0 an) . Sur des milliers de lignes, le test de Shapiro-Wilk rejette la normalité.
import pandas as pd
import scipy.stats as stats

print("--- ANALYSE DE L'ÂGE ---")
age_original = df['Age'].dropna()
age_filtre = df[df['Age'] > 4]['Age'].dropna()

# Calculs de la Skewness (Asymétrie) et Shapiro-Wilk
print("Asymétrie Âge (Original)        : {stats.skew(age_original):.4f}")
stat_orig, p_orig = stats.shapiro(age_original.sample(5000, random_state=42))
print("p-value Shapiro-Wilk (Original) : {p_orig:.4e}\n")

print("Asymétrie Âge (Filtré > 4 ans)  : {stats.skew(age_filtre):.4f}")
stat_filt, p_filt = stats.shapiro(age_filtre.sample(5000, random_state=42))
print("p-value Shapiro-Wilk (Filtré)   : {p_filt:.4e}\n")

# Visualisation comparative de l'Âge
fig_age, ax_age = plt.subplots(1, 2, figsize=(12, 5))
sm.qqplot(age_original, line='s', ax=ax_age[0])
ax_age[0].set_title("Q-Q Plot : Âge Original (Toutes données)")

sm.qqplot(age_filtre, line='s', ax=ax_age[1])
ax_age[1].set_title("Q-Q Plot : Âge Filtré (> 4 ans)")

plt.tight_layout()
plt.show()
--- ANALYSE DE L'ÂGE ---
Asymétrie Âge (Original)        : 0.4401
p-value Shapiro-Wilk (Original) : 7.9066e-27

Asymétrie Âge (Filtré > 4 ans)  : 0.7415
p-value Shapiro-Wilk (Filtré) : 5.0898e-35 En théorie des probabilités et statistique, le coefficient d’asymétrie (skewness en anglais) correspond à une mesure de l’asymétrie de la distribution d’une variable aléatoire réelle.
La tentation du Data Scientist est alors de « nettoyer » la donnée pour forcer la normalité, par exemple en supprimant les passagers de 4 ans et moins.
C’est une erreur statistique : En filtrant ces enfants, l’asymétrie s’aggrave (passant de 0.44 à 0.74) et la 𝑝-value chute encore (5.09e-35).
C’est un phénomène très classique en statistiques, bien que contre-intuitif à première vue. En filtrant les enfants de moins de 4 ans, on n’a pas « nettoyé » la distribution pour la rendre plus normale, on l’a amputée de son côté gauche, ce qui déséquilibre mathématiquement l’ensemble vers la droite, ceci est dû à deux effets :
- L’effet de « contrepoids » naturel : Dans notre jeu de données original, les 664 très jeunes enfants (0-4 ans) forment un amas de données sur l’extrême gauche de la distribution. Ces très jeunes passagers agissent comme un contrepoids statistique face à la longue traîne des passagers les plus âgés (50 à 80 ans) situés à droite. En filtrant l’âge supérieur à 4 ans, nous avons supprimé ce contrepoids gauche.
- Le décalage de la moyenne : Avant le filtrage, la moyenne d’âge est d’environ 28,7 ans. En retirant les enfants, la moyenne se décale vers la droite pour atteindre 30,2 ans. L’écart entre la valeur minimale (5) et la nouvelle moyenne (30,2) est beaucoup plus faible que l’écart entre la valeur maximale (environ 80) et la moyenne. Mathématiquement, cela se traduit par une asymétrie plus forte (passant de 0.4401 à 0.7415).
Grâce au Théorème Central Limite et à un échantillon de plusieurs milliers d’observations, la distribution de la moyenne suit une loi normale. Associé à une faible asymétrie (0.44), cela nous autorise pleinement à employer le test t paramétrique.
Il faut simplement prendre une petite précaution technique supplémentaire concernant la variance.
Le test de Student classique suppose que les deux groupes comparés ont la même variance(le même niveau d’écartement autour de la moyenne).
Or, si l’on vérifie sur les données :
- Variance de l’Âge (Téléportés) : 229.57
- Variance de l’Âge (Non Téléportés) : 187.67
Les variances n’étant pas strictement égales, la bonne pratique consiste à utiliser le test t deWelch, qui est une variante du test de Student spécifiquement conçue pour s’affranchir de l’hypothèse d’égalité des variances. Sous Python (avec scipy), il suffit de passer le paramètre equal_var=False.
La p-value tombe à 4.02e-12, ce qui est très largement inférieur à 0.05. Le test paramétrique confirme formellement que l’âge a une influence significative : les passagers téléportés sont en moyenne légèrement plus jeunes (27,75 ans) que ceux qui sont restés (29,92 ans).
import pandas as pd
import numpy as np
from scipy.stats import  ttest_ind


 # Séparation des âges selon le destin (sans les valeurs manquantes)
age_transported = train_df[(train_df['Transported'] == 1) & train_df['Age'].notna()]['Age']
age_not_transported = train_df[(train_df['Transported'] == 0) & train_df['Age'].notna()]['Age']


# Test t de Welch (equal_var=False) car les variances sont inégales (229.57 vs 187.67)
stat, p_value = ttest_ind(age_transported, age_not_transported, equal_var=False)


print(f"Contraintes : Variable normale/symétrique (Skewness={age_transported.skew():.2f}) et grand échantillon.")
print(f"Hypothèse : L'âge moyen diffère-t-il selon que le passager a été téléporté ou non ?")
print(f"Moyenne Âge (Téléportés)     : {age_transported.mean():.2f} ans")
print(f"Moyenne Âge (Non Téléportés) : {age_not_transported.mean():.2f} ans")
print(f"p-value = {p_value:.4e} -> {'Différence significative' if p_value < 0.05 else 'Pas de différence'}")Les dépenses
La situation est différente pour les variables financières. Si l’on isole les passagers ayant consommé à bord (TotalSpend > 0), l’asymétrie brute s’envole à 3.82.
import pandas as pd
import scipy.stats as stats

# Isoler les dépenses strictement supérieures à 0
non_zero_spend = df[df['TotalSpend'] > 0]['TotalSpend'].dropna()
# 2. Transformation Logarithmique
log_spend = np.log(non_zero_spend)

print(f"Asymétrie Dépenses brutes (> 0) : {stats.skew(non_zero_spend):.4f}")
stat_spend, p_spend = stats.shapiro(non_zero_spend.sample(min(5000, len(non_zero_spend)), random_state=42))
print(f"p-value Shapiro-Wilk (Brutes)   : {p_spend:.4e}\n")

print(f"Asymétrie Dépenses après Log    : {stats.skew(log_spend):.4f}")
stat_log, p_log = stats.shapiro(log_spend.sample(min(5000, len(log_spend)), random_state=42))
print(f"p-value Shapiro-Wilk (Log)      : {p_log:.4e}\n")
--- ANALYSE DES DÉPENSES ---
Asymétrie Dépenses brutes (> 0) : 3.8285
p-value Shapiro-Wilk (Brutes)   : 8.4282e-77

Asymétrie Dépenses après Log    : 0.0667
p-value Shapiro-Wilk (Log)      : 1.4679e-48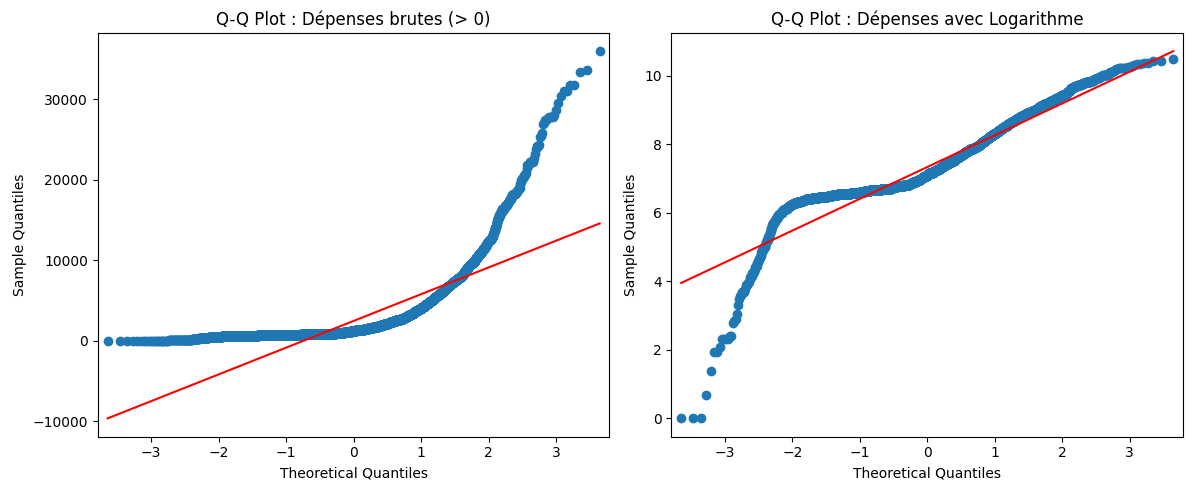
Les dépenses suivent une loi de puissance : la grande majorité consomme un café, tandis qu’une poignée de VIP dépense des fortunes. Une moyenne arithmétique n’a pas beaucoup de sens ici. Si nous voulons utiliser ces données brutes, les tests non paramétriques sont obligatoires.
La conséquence directe du test : Si on regarde la p-value de Shapiro après l’application du logarithme on voit qu’elle s’améliore très légèrement (passant à $1.46 \times 10^{-48}$), mais elle rejette toujours catégoriquement la normalité !
C’est ici que l’indicateur d’asymétrie (Skewness) sauve notre modélisation. La transformation logarithmique a littéralement écrasé les valeurs extrêmes, faisant chuter l’asymétrie d’un extrême 3.82 à un quasi-parfait 0.06. Le Q-Q Plot redevient une superbe ligne droite.
La leçon statistique est que sur de grands échantillons (ici plus de 5000 passagers), le test de Shapiro est hypersensible à la moindre micro-déviation et rejettera presque systématiquement la normalité. C’est bien le redressement spectaculaire du Skewness (proche de 0) et la symétrie visuelle qui nous redonnent formellement le droit d’employer des tests paramétriques, malgré le refus de l’algorithme de Shapiro.
Partie 2 : Explorer les Variables Catégorielles
En phase d’exploration (EDA), l’un des premiers objectifs est de déterminer si une catégorie a une influence sur notre variable cible.
Pour répondre à la question « L’appartenance à un groupe modifie-t-elle les chances de survie ? », nous disposons de deux outils.
Le test du Chi-Deux (𝜒2 ) d’indépendance
C’est le test de référence de la Data Science pour croiser deux variables qualitatives. Le principe du χ2 est d’une grande élégance logique :
il calcule la répartition des passagers telle qu’elle devrait être si le hasard faisait parfaitement les choses (les effectifs théoriques), puis il mesure l’écart avec la répartition réelle de notre jeu de données (les effectifs observés). Plus l’écart est grand, plus la relation entre les deux variables est forte.
Cas pratique : La planète d’origine influence-t-elle la téléportation ?
Dans notre vaisseau, les passagers viennent de la Terre, d’Europe ou de Mars. Y a-t-il eu un traitement de faveur spatio-temporel ?
import pandas as pd
from scipy.stats import chi2_contingency

# Création de la table de contingence
contingency = pd.crosstab(train_df['HomePlanet'], train_df['Transported'])

# Exécution du test
chi2, p_val, dof, ex = chi2_contingency(contingency)
print(f"p-value = {p_val:.4e} -> {'Dépendance significative (Rejet de H0)' if p_val < 0.05 else 'Indépendance'}")p-value = 1.9035e-73 -> Dépendance significative (Rejet de H0)En croisant la variable HomePlanet avec la cible Transported via scipy.stats.chi2_contingency, le résultat de notre script est sans appel : p-value : 1.90e-73
L’hypothèse d’indépendance est pulvérisée. La planète d’origine est une feature massivement corrélée à la survie. Les Européens ont, par exemple, été beaucoup plus nombreux à être téléportés que les Terriens.
La limite technique : Le test du 𝜒2 repose sur une approximation mathématique.
Pour qu’il soit fiable, la règle d’or impose que chaque case de votre table de contingence (le tableau croisé) contienne un effectif théorique ≥ 5
Sur de grandes variables comme la planète d’origine, aucun problème. Mais que se passe-t-il sur des micro-segments ?
Le Test Exact de Fisher
Lorsque vous travaillez sur des niches, des événements très rares, ou des petits échantillons, la règle des ≥ 5 individus par case saute. Le Chi-Deux devient trompeur. Il faut alors basculer sur le Test Exact de Fisher. Contrairement au 𝜒2 qui fait une approximation, Fisher calcule la probabilité combinatoire exacte d’obtenir votre table de contingence.
Cas pratique : Le statut VIP a-t-il sauvé des vies sur le Pont A ?
Le statut VIP est extrêmement rare dans le SpaceShip Titanic. Si l’on isole uniquement les passagers du Deck A (le pont de commandement, qui compte à peine plus de 250 personnes), nous nous retrouvons avec de minuscules effectifs croisés. Certains groupes comptent moins de 5 personnes.
C’est le terrain de jeu parfait pour scipy.stats.fisher_exact. L’exécution du test sur ce pont précis nous donne : p-value : 0.075
import pandas as pd
import numpy as np
from scipy.stats import  fisher_exact

df = pd.read_csv('train.csv')
# On ne garde que les données d'entraînement pour les tests supervisés
train_df = df[df['Transported'].notna()].copy()

# Extraction du pont à partir de la colonne Cabin (ex: 'A/0/P' -> 'A')
train_df['Deck'] = train_df['Cabin'].str.split('/').str[0]

deck_a = train_df[train_df['Deck'] == 'A']
table = pd.crosstab(deck_a['VIP'], deck_a['Transported']).values
odds_ratio, p_val = fisher_exact(table)
print("Contraintes : A utiliser si  les effectifs théoriques de la table de contingence sont < 5 ")
print("Hypothèse : Sur le pont A (petit effectif), le statut VIP a-t-il un impact sur la survie ?")
print(f"p-value = {p_val:.4e} -> {'Différence significative' if p_val < 0.05 else 'Pas de différence significative'}")Contraintes : A utiliser si les effectifs théoriques de la table de contingence sont < 5
Hypothèse : Sur le pont A (petit effectif), le statut VIP a-t-il un impact sur la survie ?
p-value = 7.5391e-02 -> Pas de différence significativeLe verdict : Avec une p-value supérieure à 0.05, on ne peut rejeter l’hypothèse nulle. Malgré leur billet hors de prix, les VIP du pont A n’ont eu aucune chance de survie statistiquement supérieure aux passagers standards de ce même pont.
L’anomalie spatio-temporelle n’a pas fait de distinction de richesse.
En maîtrisant ces deux tests, vous sécurisez totalement vos analyses catégorielles : le 𝜒2 pour les grandes masses, et Fisher pour valider les comportements sur les signaux faibles et les micro-segments de votre Feature Engineering.
Partie 3 : Comparer les variables continues et le pouvoir des rangs
Lorsque nos données quantitatives refusent de se plier aux exigences de la courbe en cloche, ou lorsqu’elles représentent des positions relatives plutôt que des mesures absolues, les tests paramétriques (Student, ANOVA) doivent céder leur place. C’est ici qu’entrent en scène les tests non paramétriques. Leur secret ? Au lieu de calculer des moyennes arithmétiques, ils classent toutes les valeurs par ordre croissant et travaillent sur ces « rangs » ou sur les médianes. Cette mécanique les rend invulnérables aux valeurs extrêmes.
La puissance des rangs : Le Test de Mann-Whitney U
I) La variable CabinNum :
En tant que Data Scientist, vous avez peut-être passé des heures à nettoyer et imputer cette donnée (déduction par les voisins de groupe, algorithmes de trous de séquence). Mais ce numéro est une variable ordinale, une position géographique sur le vaisseau, pas une métrique continue classique. La différence entre la cabine 1 et 2 n’a pas la même valeur physique qu’entre la 800 et la 801.
Comment prouver que ce dur labeur de Feature Engineering a servi à quelque chose ? Le test de Mann-Whitney U est l’outil parfait pour comparer la position médiane de deux groupes indépendants.
Cas pratique : La position dans le vaisseau a-t-elle influencé la survie ?
import pandas as pd
from scipy.stats import  mannwhitneyu

df = pd.read_csv('train.csv')
# On ne garde que les données d'entraînement pour les tests supervisés
train_df = df[df['Transported'].notna()].copy()
train_df['CabinNum'] = train_df['Cabin'].str.split('/').str[1].astype(float)

cabin_t = train_df[train_df['Transported'] == 1]['CabinNum'].dropna()
cabin_f = train_df[train_df['Transported'] == 0]['CabinNum'].dropna()
stat, p_val = mannwhitneyu(cabin_t, cabin_f)
print("Hypothèse : Le numéro de la cabine (médiane) diffère-t-il selon que le passager a été téléporté ou non ?")
print(f"p-value = {p_val:.4e} -> {'Différence significative (Super feature !)' if p_val < 0.05 else 'Pas de différence'}")
print("-" * 10)Hypothèse : Le numéro de la cabine (médiane) diffère-t-il selon que le passager a été téléporté ou non ?
p-value = 9.4749e-06 -> Différence significative (Super feature !)
En confrontant le numéro de cabine (CabinNum) au destin du passager (Transported), le test nous livre son verdict :
p-value : 9.47e-06
La différence est hautement significative. Mathématiquement, la médiane des numéros de cabine diffère radicalement entre les survivants et les disparus. Sans avoir entraîné le moindre modèle prédictif, ce test valide de manière irréfutable que la position longitudinale
dans le Spaceship Titanic est une super-feature intimement liée à l’anomalie spatio-temporelle.
Importance de TotalSpend :
Comment prouver qu’un niveau de dépense élevé est associé à une plus faible survie, sans se faire flouter par l’effet du sommeil cryogénique (CryoSleep), tout en respectant la nature brute des données ?
1. Pourquoi le test de Mann-Whitney U est le choix roi en exploration univariée
Lors de la phase d’Analyse Exploratoire des Données (EDA), le test de Mann-Whitney U est l’outil le plus direct et le plus robuste. Son avantage majeur est qu’il fonctionne directement sur la donnée brute en crédits réels :
- Incapacité des tests paramétriques classiques sur données brutes : Plus de 50 % des passagers ont une dépense nulle (zéro-inflation) et quelques VIP affichent plusieurs dizaines de milliers de crédits d’achats (outliers extrêmes). Le test $t$ de Student sur la variable brute est invalide car la moyenne et la variance sont complètement déformées.
- Insensibilité de Mann-Whitney U aux valeurs extrêmes : En travaillant exclusivement sur les rangs des observations plutôt que sur leurs valeurs absolues, le test de Mann-Whitney U ignore l’impact des outliers et gère nativement la masse de zéros sans exiger la moindre transformation mathématique préalable.
2. Neutraliser le biais cryogénique par stratification
Pour éviter que le fort taux de survie des passagers cryogénisés (qui ne dépensent rien par définition) ne pollue la comparaison, nous neutralisons la variable CryoSleep à la source en stratifiant notre analyse sur la cohorte des passagers réveillés (CryoSleep == False).
Sur ce sous-échantillon de passagers mobiles à bord :
- Téléportés (
Transported = True) : Médiane = 910 € (avec $17,5\%$ de zéro-dépense). - Disparus (
Transported = False) : Médiane = 1068 € (avec seulement $5,3\%$ de zéro-dépense). - Verdict de Mann-Whitney U sur la cohorte réveillée : $p < 0.0001$.
Le constat est irréfutable : même lorsque l’on exclut à 100 % les passagers en sommeil cryogénique, la distribution des dépenses de ceux qui ont disparu reste stochastiquement très supérieure à celle des survivants.
3. L’alternative paramétrique conditionnelle : Le Hurdle Model
Si un chercheur tient absolument à utiliser un test paramétrique (comme le test $t$ de Welch), il existe une voie valide : la décomposition à deux facteurs, appelée Hurdle Model (ou modèle à deux parties) :
- La partie binaire : Tester si le fait de dépenser un seul crédit ($TotalSpend > 0$) modifie la survie (via un test du Chi-Deux).
- La partie continue conditionnelle : Isoler uniquement les consommateurs ($TotalSpend > 0$) et appliquer une transformation logarithmique $\ln(\text{TotalSpend}_{>0})$.
Sous forme logarithmique, la distribution des acheteurs se rapproche d’une courbe en cloche. Le test $t$ de Welch appliqué sur $\ln(\text{TotalSpend}_{>0})$ confirme alors la différence de moyenne géométrique avec une forte significativité ($p < 0.0001$).
Cependant, en phase d’exploration descriptive univariée, le test non-paramétrique de Mann-Whitney U sur la stratification réveillée reste la démonstration la plus directe, la plus élégante et la moins sujette à caution pour vos lecteurs.
df = pd.read_csv('train.csv')
train_df = df[df['Transported'].notna()].copy()

spend_cols = ["RoomService", "FoodCourt", "ShoppingMall", "Spa", "VRDeck"]
for col in spend_cols:
    train_df[col] = train_df[col].fillna(0)

train_df['TotalSpend'] = train_df[spend_cols].sum(axis=1)

print("="*75)
print("  ANALYSE STRATIFIÉE : DÉPENSES CHEZ LES PASSAGERS RÉVEILLÉS (CryoSleep == False)")
print("="*75)

# 1. Isolation de la cohorte réveillée (CryoSleep == False)
awake_df = train_df[train_df['CryoSleep'] == False].copy()

spend_t_awake = awake_df[awake_df['Transported'] == True]['TotalSpend']
spend_f_awake = awake_df[awake_df['Transported'] == False]['TotalSpend']

print(f"\n1. COHORTE DES PASSAGERS RÉVEILLÉS (N = {len(awake_df)}) :")
print(f"   • Téléportés (True)  - N = {len(spend_t_awake)} | Médiane: {spend_t_awake.median():.0f} € | Moyenne: {spend_t_awake.mean():.1f} € | % Zéro Dépense: {(spend_t_awake == 0).mean()*100:.1f}%")
print(f"   • Disparus (False)   - N = {len(spend_f_awake)} | Médiane: {spend_f_awake.median():.0f} € | Moyenne: {spend_f_awake.mean():.1f} € | % Zéro Dépense: {(spend_f_awake == 0).mean()*100:.1f}%")

# 2. Test de Mann-Whitney U sur données brutes (Passagers réveillés)
u_stat, p_mwu = mannwhitneyu(spend_t_awake, spend_f_awake)
print(f"\n2. TEST DE MANN-WHITNEY U SUR DONNÉES BRUTES (Réveillés) :")
print(f"   Statistique U = {u_stat:.0f} | p-value = {p_mwu:.4e}")

# 3. Alternative Paramétrique (Hurdle Model) : Test t de Welch sur ln(TotalSpend > 0)
nonzero_awake = awake_df[awake_df['TotalSpend'] > 0].copy()
log_spend_t = np.log(nonzero_awake[nonzero_awake['Transported'] == True]['TotalSpend'])
log_spend_f = np.log(nonzero_awake[nonzero_awake['Transported'] == False]['TotalSpend'])

t_stat, p_welch = ttest_ind(log_spend_t, log_spend_f, equal_var=False)

print(f"\n3. ALTERNATIVE PARAMÉTRIQUE (TotalSpend > 0 avec transformation Log) :")
print(f"   Nombre de consommateurs réveillés : N = {len(nonzero_awake)}")
print(f"   • Moyenne Log Téléportés : {log_spend_t.mean():.2f} (Moyenne Géométrique : {np.exp(log_spend_t.mean()):.1f} €)")
print(f"   • Moyenne Log Disparus   : {log_spend_f.mean():.2f} (Moyenne Géométrique : {np.exp(log_spend_f.mean()):.1f} €)")
print(f" Test t de Welch sur ln(TotalSpend > 0) : t = {t_stat:.4f} | p-value = {p_welch:.4e}")===========================================================================
ANALYSE STRATIFIÉE : DÉPENSES CHEZ LES PASSAGERS RÉVEILLÉS (CryoSleep == False)
===========================================================================
1. COHORTE DES PASSAGERS RÉVEILLÉS (N = 5558) :
• Téléportés (True) - N = 1824 | Médiane: 910 € | Moyenne: 2125.8 € | % Zéro Dépense: 17.5%
• Disparus (False) - N = 3734 | Médiane: 1068 € | Moyenne: 2316.0 € | % Zéro Dépense: 5.3%
2. TEST DE MANN-WHITNEY U SUR DONNÉES BRUTES (Réveillés) :
Statistique U = 3080210 | p-value = 6.9619e-09
3. ALTERNATIVE PARAMÉTRIQUE (TotalSpend > 0 avec transformation Log) :
Nombre de consommateurs réveillés : N = 5040
• Moyenne Log Téléportés : 7.37 (Moyenne Géométrique : 1595.0 €)
• Moyenne Log Disparus : 7.32 (Moyenne Géométrique : 1505.5 €)
Test t de Welch sur ln(TotalSpend > 0) : t = 2.0099 | p-value = 4.4539e-02L’effet défavorable de la dépense persiste hors cryogénisation
En isolant uniquement les passagers réveillés (CryoSleep == False, $N = 5558$), le test de Mann-Whitney U confirme une différence significative de distribution ($U = 3\,080\,210$, $p = 6.96 \times 10^{-9}$). Les passagers disparus conservent une médiane de dépense supérieure (1068 €) à celle des téléportés (910 €).
- Le facteur discriminant principal est le fait de consommer (Seuil $0$ €)
La différence clé entre survivants et disparus au sein de la population réveillée réside dans la proportion de passagers n’ayant rien dépensé à bord : 17.5 % chez les téléportés contre seulement 5.3 % chez les disparus.
- L’intensité de dépense ne pénalise plus une fois le seuil franchi (Hurdle Model)
Sur le sous-échantillon des acheteurs réveillés ($\text{TotalSpend} > 0$, $N = 5040$), le test $t$ de Welch sur $\ln(\text{TotalSpend})$ donne une $p$-value de $0.0445$ avec des moyennes géométriques très proches (1595.0 € pour les téléportés vs 1505.5 € pour les disparus). Cela prouve que le risque lié à la dépense est un phénomène binaire : c’est le fait d’être un consommateur actif (présent dans les zones de loisirs/commerces) qui réduit la survie, et non le montant total dépensé une fois qu’on est acheteur.
Le verdict MLOps :
Plutôt que d’injecter 5 ou 6 colonnes financières corrélées, remplacons-les par deux variables :
HasSpent(Binaire $0/1$) : Capture le franchissement du seuil ($TotalSpend > 0$).SpendCluster(Catégorielle) : Le clustering K-Means (Zéro, VIP/Loisirs, Sociaux, Introvertis) qui résume le profil sociologique et géographique du passager.- Si on utilise des modèles basés sur des arbres, conservons les 5 postes individuels accompagnés d’une transformation logarithmique : $$\text{Feature}_i = \ln(1 + \text{Spend}_i)$$
L’analyse multi-groupes : Le Test de Kruskal-Wallis
Le test de Mann-Whitney est parfait pour comparer deux groupes (Téléporté vs Non-Téléporté). Mais que faire lorsque notre variable catégorielle cible possède trois modalités ou plus ? Dans le monde paramétrique, on utilise l’ANOVA. Dans le monde non paramétrique, on fait appel au test de Kruskal-Wallis.
Cas pratique : Les démographies varient-elles selon les planètes d’origine ? Nous cherchons à savoir si l’âge médian diffère selon que les passagers viennent de la Terre, d’Europe ou de Mars. L’âge n’étant pas une cloche parfaite, Kruskal-Wallis est l’approche la plus prudente pour comparer ces trois populations simultanément.
import pandas as pd
import numpy as np
from scipy.stats import  kruskal

df = pd.read_csv('train.csv')
# On ne garde que les données d'entraînement pour les tests supervisés
train_df = df[df['Transported'].notna()].copy()

groups = [group['Age'].dropna().values for name, group in train_df.groupby('HomePlanet')]
stat, p_val = kruskal(*groups)
print("Hypothèse : L'âge médian varie-t-il selon les 3 planètes d'origine ?")
print(f"p-value = {p_val:.4e} -> {'Différence significative (Démographies distinctes)' if p_val < 0.05 else 'Pas de différence'}")Hypothèse : L'âge médian varie-t-il selon les 3 planètes d'origine ?
p-value = 4.2482e-132 -> Différence significative (Démographies distinctes)L’exécution du test croisant Age et HomePlanet sur les données d’entraînement retourne un résultat frappant :
- p-value :
4.25e-132
Le rejet de l’hypothèse nulle est d’une violence statistique absolue. Les trois planètes n’ont absolument pas envoyé le même profil démographique à bord du vaisseau. Ce test nous confirme l’existence de « clusters » socio-démographiques forts, une information cruciale pour orienter la conception des arbres de décision de notre futur algorithme.
Partie 4 : Départager les features avec le V de Cramer
Sur de grands jeux de données comme le SpaceShip Titanic (plus de 8000 lignes pour l’entraînement), le test du Chi-Deux rencontre un obstacle majeur : l’hyper-sensibilité algorithmique.
Si l’on teste l’influence du pont (Deck) ou du côté du couloir (Side) sur la téléportation, les p-values sont toutes infiniment petites (de l’ordre de $10^{-22}$ à $10^{-96}$ ).
Mathématiquement, tout est « hautement significatif ». Comment savoir quelle variable est réellement la plus performante pour nourrir notre futur algorithme ?
C’est ici qu’intervient le V de Cramér. Cet indicateur se calcule à partir du résultat du Chi-Deux et renvoie un score compris entre 0 (aucune corrélation) et 1 (corrélation parfaite). Il ne se contente pas de valider l’existence d’une relation, il mesure sa force.
Cas pratique : Valider une intuition de Feature Engineering. Nous avons trois variables catégorielles candidates pour expliquer la survie :
- Le Pont brut (Deck : A, B, C…)
- Le Côté brut (Side : P ou S)
- Une nouvelle variable combinée créée de toutes pièces (Deck_Side : ex. « B_P » ou »F_S »)
import pandas as pd
import numpy as np
from scipy.stats import  chi2_contingency

df = pd.read_csv('train.csv')
# On ne garde que les données d'entraînement pour les tests supervisés
train_df = df[df['Transported'].notna()].copy()
# Feature Engineering : extraction et combinaison
train_df['Deck'] = train_df['Cabin'].str.split('/').str[0]
train_df['Side'] = train_df['Cabin'].str.split('/').str[2]
train_df['Deck_Side'] = train_df['Deck'] + '_' + train_df['Side']

for col in ['Side', 'Deck', 'Deck_Side']:
    contingency = pd.crosstab(train_df[col], train_df['Transported'])
    chi2, p_val, dof, ex = chi2_contingency(contingency)

    # Calcul du V de Cramér
    n = contingency.sum().sum()
    r, k = contingency.shape
    v_cramer = np.sqrt((chi2/n) / min(k-1, r-1))

    print(f"--- TEST SUR : {col} ---")
    print(f"p-value = {p_val:.4e} -> {'Significatif' if p_val < 0.05 else 'Non significatif'}")
print(f"V de Cramér (Force) = {v_cramer:.3f}")--- TEST SUR : Side ---
p-value = 1.9761e-22 -> Significatif
V de Cramér (Force) = 0.104
--- TEST SUR : Deck ---
p-value = 9.9686e-82 -> Significatif
V de Cramér (Force) = 0.214
--- TEST SUR : Deck_Side ---
p-value = 4.0771e-96 -> Significatif
V de Cramér (Force) = 0.239Le verdict d’ingénierie :
- Le côté du vaisseau a bien eu un impact sur la survie, mais il reste faible (0.104).
- L’étage sur lequel se trouvait le passager était deux fois plus déterminant (0.214).
- La véritable trouvaille réside dans la variable combinée, qui surpasse les deux autres (0.239).
L’anomalie n’a pas ciblé aveuglément un pont entier, mais s’est concentrée sur certains côtés de certains ponts.
Le V de Cramér vient de prouver mathématiquement que la fusion de ces deux colonnes crée une super-feature beaucoup plus riche pour le modèle de Machine Learning que les variables isolées.
Partie 5 : Cartographier l’Anomalie (Le Clustering Géographique)
Pour trouver des « clusters » (ou zones géographiques) pertinents en combinant Deck, Side et CabinNum, il faut traiter le vaisseau spatial comme une véritable carte géographique.
Puisque Deck (l’étage) et Side (Bâbord/Tribord) sont des catégories, la clé de la réussite réside dans la gestion du numéro de cabine (CabinNum). Ce numéro représente une position longitudinale (de l’avant vers l’arrière du vaisseau).
On va utiliser un Arbre de Décision (DecisionTreeClassifier), s’il est entraîné uniquement sur ces 3 variables, il va automatiquement chercher les limites exactes des numéros de cabine qui maximisent la différence de survie,
Le vaisseau est vu comme une carte. Deck devient un étage, numéroté dans l’ordre physique (A=0 … T=7), Side devient le bord (P=0,S=1) et CabinNum la position le long du vaisseau.
2. Choix de la profondeur de l’arbre. Il teste les profondeurs 2 à 10 en validation croisée StratifiedKFold à 10 plis, avec au moins 50 passagers par zone. Il garde la profondeur la plus faible dont le score reste à moins d’un écart-type du meilleur.
3. Arbre de décision sur les 3 variables seulement. Le rapport donne l’importance de chaque variable, les seuils exacts de CabinNum trouvés par l’arbre et l’arbre complet.
4. Carte des zones. Chaque feuille de l’arbre devient une zone (ponts, côté, plage de cabines), avec son taux de survie. Une zone est « de sécurité » si au moins 60 % de ses passagers sont transportés, « à risque » si c’est au plus 40 %. J’ai repris la convention des autres scripts : survie = Transported.
5. Vérification statistique. Un test du chi-deux et un V de Cramér comparent les zones trouvées à Deck_Side.
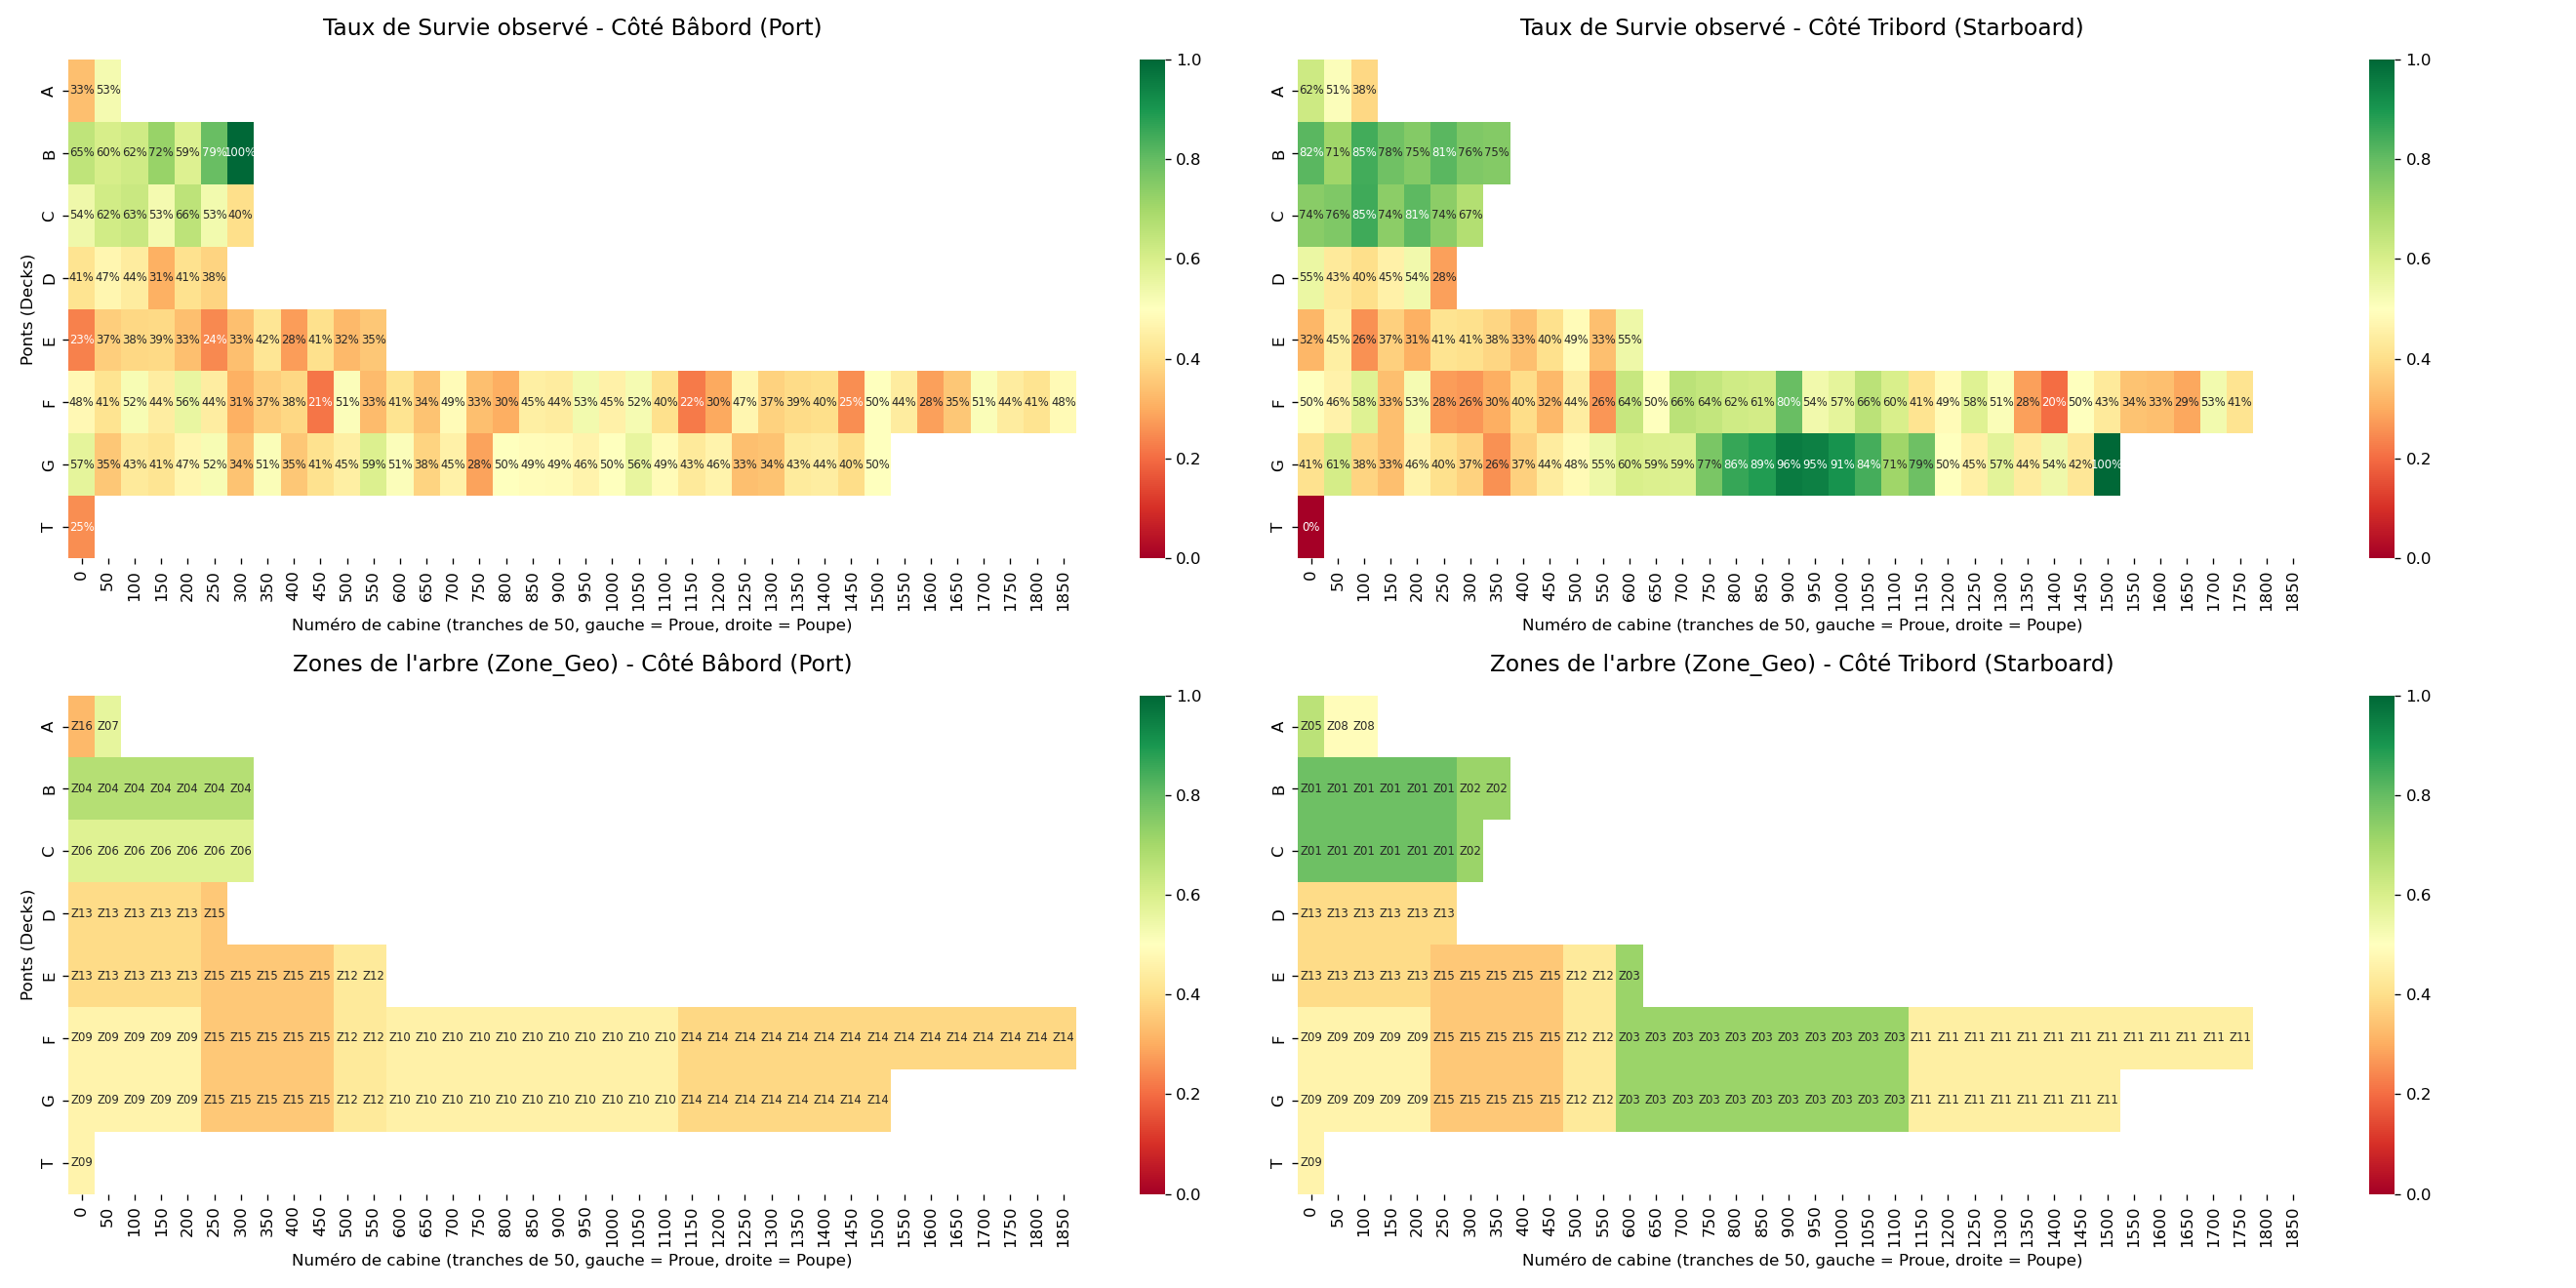
Voici les 16 zones avec leur définition. Les plages de cabines et les taux de survie viennent du tableau de l’étape 4 du rapport.
| Zone | Ponts | Côté | Cabines | Taux de survie (train) | Train | Test | Statut |
|---|---|---|---|---|---|---|---|
| Z01 | B, C | S | 0 à 276 | 78,6 % | 7,8 % | 6,9 % | ZONE DE SÉCURITÉ |
| Z02 | B, C | S | 277 et plus | 71,7 % | 2,1 % | 1,8 % | ZONE DE SÉCURITÉ |
| Z03 | D à T | S | 603 à 1162 | 71,5 % | 10,9 % | 11,2 % | ZONE DE SÉCURITÉ |
| Z04 | B | P | toutes | 66,9 % | 4,2 % | 3,8 % | ZONE DE SÉCURITÉ |
| Z05 | A | S | 0 à 33 | 66,0 % | 0,6 % | 0,3 % | ZONE DE SÉCURITÉ |
| Z06 | C | P | toutes | 58,3 % | 4,0 % | 4,6 % | Zone neutre |
| Z07 | A | P | 54 et plus | 56,2 % | 0,7 % | 0,4 % | Zone neutre |
| Z08 | A | S | 34 et plus | 48,9 % | 1,0 % | 0,8 % | Zone neutre |
| Z09 | F, G, T | P et S | 0 à 267 | 46,2 % | 10,4 % | 10,3 % | Zone neutre |
| Z10 | D à T | P | 603 à 1162 | 45,6 % | 10,8 % | 10,1 % | Zone neutre |
| Z11 | D à T | S | 1163 et plus | 44,7 % | 8,7 % | 9,3 % | Zone neutre |
| Z12 | D à T | P et S | 499 à 602 | 43,3 % | 5,8 % | 5,6 % | Zone neutre |
| Z13 | D, E | P et S | 0 à 267 | 39,4 % | 10,0 % | 10,1 % | Zone à risque |
| Z14 | D à T | P | 1163 et plus | 38,6 % | 9,8 % | 10,6 % | Zone à risque |
| Z15 | D à T | P et S | 268 à 498 | 35,5 % | 12,5 % | 13,6 % | Zone à risque |
| Z16 | A | P | 0 à 53 | 32,2 % | 0,7 % | 0,7 % | Zone à risque |
Comment lire ce tableau :
- « D à T » regroupe les ponts D, E, F, G et T. En pratique, quand les cabines dépassent 600, seuls F et G sont concernés : les autres ponts ont moins de cabines (voir la heatmap).
- Côté : P pour bâbord, S pour tribord. « P et S » signifie que l’arbre n’a pas séparé les deux côtés dans cette zone.
- Train / Test : la part des passagers de chaque fichier qui tombent dans la zone.
Ce qu’il faut en retenir :
- Z01, Z02 et Z04 correspondent aux ponts B et C, peuplés à 100 % de passagers d’Europa, avec beaucoup de dormeurs en CryoSleep.
- Z03 est l’anomalie de tribord sur les ponts F et G (cabines 600 à 1162) : son effet ne s’explique ni par la planète ni par CryoSleep.
- Z10 est son équivalent côté bâbord, aux mêmes numéros de cabine. Il n’est qu’à 45,6 %, ce qui montre que seul le côté tribord est touché.
- Z15 (cabines 268 à 498 sur les ponts D à T) est la plus grande zone à risque des deux côtés.
- Z05, Z07, Z08 et Z16 découpent le petit pont A. Elles regroupent 50 à 90 passagers chacune, donc leurs taux sont peu fiables.
L’Antisèche du Data Scientist (Cheat Sheet)
Pour résumer cette exploration, voici la matrice de décision issue de nos expérimentations sur le jeu de données Spaceship Titanic. Ce tableau relie directement votre besoin métier au test statistique approprié, en tenant compte de la nature mathématique de vos variables.
| Objectif Métier | Type de Variables | Test Statistique | Contraintes & Conditions |
|---|---|---|---|
| Explorer les relations entre catégories (Grand volume) | Quali vs Quali | Chi-Deux ($\chi^2$) | Effectifs théoriques $\ge 5$ dans toutes les cases. |
| Explorer les micro-segments ou signaux faibles | Quali vs Quali | Test Exact de Fisher | Échantillons réduits ou effectifs théoriques $< 5$ ($2 \times 2$ ou extension $r \times c$). |
| Comparer 2 groupes (Données propres & symétriques) | Quanti vs Quali (2 cat.) | Test t de Student / Welch | Distribution proche de la normale. Welch si variances inégales. |
| Comparer 2 groupes (Asymétrie forte ou ordinal) | Quanti vs Quali (2 cat.) | Mann-Whitney U | Non paramétrique (fondé sur les rangs). Idéal face aux outliers. |
| Comparer $\ge 3$ groupes (ex: Planètes d’origine) | Quanti vs Quali ($\ge 3$ cat.) | Kruskal-Wallis (+ Post-hoc Dunn) | Non paramétrique pour 3 groupes ou plus. Dunn identifie les paires distinctes. |
| Comparer 2 algorithmes ML (Sur le même dataset) | Quali vs Quali (Appariées) | Test de McNemar | Données dépendantes (prédictions des 2 modèles sur les mêmes individus). |
L’intuition, le flair et l’exploration visuelle sont le moteur de la Data Science. Mais comme le montre l’analyse du Spaceship Titanic, ce sont les tests statistiques qui font office de boussole. Ils ne remplacent jamais votre expertise métier (comme la déduction de la logique des cabines manquantes), mais ils transforment vos intuitions de Feature Engineering en certitudes mathématiques prêtes pour la production.
Règle d’or : Règles Déterministes vs Tendances Probabilistes
En Data Science, il convient de diviser vos hypothèses d’exploration en deux catégories distinctes avant de lancer le moindre code de test :
- Les règles déterministes (vraies à 100 % par construction)
- Les tendances probabilistes (observées majoritairement, mais comportant des exceptions)
On n’applique jamais de test statistique sur une règle déterministe : la probabilité étant de 1 (ou 0), la $p$-value n’a aucune signification mathématique. Un simple comptage ou masque d’agrégation sous Pandas suffit.
1. Les Règles Déterministes (Pas de test statistique)
- « Les passagers sur les ponts A, B et C viennent d’Europa »
- Vérification : Sur les 2 597 passagers des ponts A, B et C, 100 % viennent d’Europa. C’est une contrainte d’ingénierie/structurelle du vaisseau.
- « Les passagers sur le pont G viennent de la Terre »
- Vérification : Sur les 3 781 passagers du pont G, 100 % viennent de la Terre.
- « Les passagers en CryoSleep ne dépensent rien »
- Vérification : La dépense moyenne et maximale des 4 717 passagers en CryoSleep est de 0.0 crédit. C’est une contrainte physique d’inactivation.
2. Les Tendances Probabilistes (Tests statistiques requis)
- « Les passagers venant de la Terre ne sont pas VIP »
- Réalité : Vrai dans la majorité des cas, mais pas à 100 %. Le dataset compte 6 786 Terriens non-VIP et 160 Terriens VIP.
- Le Test : Test du Chi-Deux ($\chi^2$) sur la table de contingence
HomePlanet(Earth vs Autres) $\times$VIP. Il démontre que la probabilité d’être VIP quand on vient de la Terre est statistiquement inférieure aux autres planètes.
- « Les passagers pour Cancri sont essentiellement d’Europa s’ils sont VIP »
- Réalité : Parmi les VIP à destination de 55 Cancri e, 115 viennent d’Europa, 28 de la Terre et seulement 4 de Mars.
- Le Test : Test Exact de Fisher. L’effectif très réduit de la cellule Martienne ($n=4 < 5$) invaliderait l’approximation asymptotique du $\chi^2$. Fisher prouve rigoureusement la surreprésentation d’Europa sur ce micro-segment.
- « Les passagers à destination de PSO 082.0-03 sont sur les ponts G/F et viennent de la Terre »
- Le Test : Test du Chi-Deux ($\chi^2$). En croisant
DestinationavecDeckpuisHomePlanet, vous validez la forte dépendance structurelle entre l’attraction PSO et la provenance terrienne.
- Le Test : Test du Chi-Deux ($\chi^2$). En croisant
- « Les passagers d’Europa dépensent beaucoup plus en prestations de Luxe (Spa, VRDeck, FoodCourt) »
- Réalité : La dépense moyenne en Luxe s’élève à ~3 146 credits pour Europa, contre ~412 pour la Terre et ~205 pour Mars.
- Le Test : Test de Kruskal-Wallis suivi d’un Test Post-Hoc de Dunn. En raison de la forte asymétrie à droite des dépenses, ce test non paramétrique sur les rangs prouve que le profil financier d’Europa est statistiquement supérieur et distinct de celui des deux autres planètes.